從 2010 年代起,隨著 GPU 與平行運算能力提升,以及大規模資料集與深度學習方法的發展,人工智慧再次快速進展,形成今日常被稱為第三波 AI 浪潮的發展階段。2022 年下半年,ChatGPT、Midjourney、Stable Diffusion 等基於大型語言模型或擴散模型的生成式 AI 應用鋪天蓋地而來。這些模型以機率分布為基礎生成內容,也使「隨機性」開始成為大眾直接接觸 AI 生成機制的一部分。AI 所造成的衝擊,已經開始不僅止於「重複性勞動」、「大批量資訊處理」等過去被認為AI較擅長的任務,各類設計、文字、音樂、影視製作等過去被認為高度仰賴「創意」的行業,也開始受到AI不同程度的影響。
那麼,藝術家是如何思考與面對AI所掀起的滔天巨浪呢?AI 演算法工程師在實務上又是如何進行試圖讓AI更具創意的「創意工程」?
本系列文章將分為三個章節,分別由來自陽春麵研究舍的陳姿尹及莊向峰,與曾合作多件作品的演算法工程師陳宣伯進行撰寫。第一章由姿尹以藝術創作者的觀點,從作品案例分析出發,第二章由宣伯從演算法工程師觀點切入討論並回應,第三章則由同時具備兩種身分的向峰再次回應與延伸討論。試圖從不同的身分與實際工作經驗,探討AI與藝術、創意之間的關係。
一、共識決的藝術與創意?
無論是在臺灣,或是在國際間的各項補助、徵件與競賽中,「共識決」都是評審團相當普遍的評審方式之一。這似乎意味著,藝術作品的好壞,某種程度上可以透過共識決來判斷。這樣的推論一旦成立,那麼對於擅長歸納、學習並預測「共識」的AI而言,是否也就有了學習「理想藝術」的可能?而如果藝術的創作與評價都能被歸納為某種可學習的模式,那麼,創意是否也能因此被學習、被預測,甚至被生成?
尋找理想藝術的共識
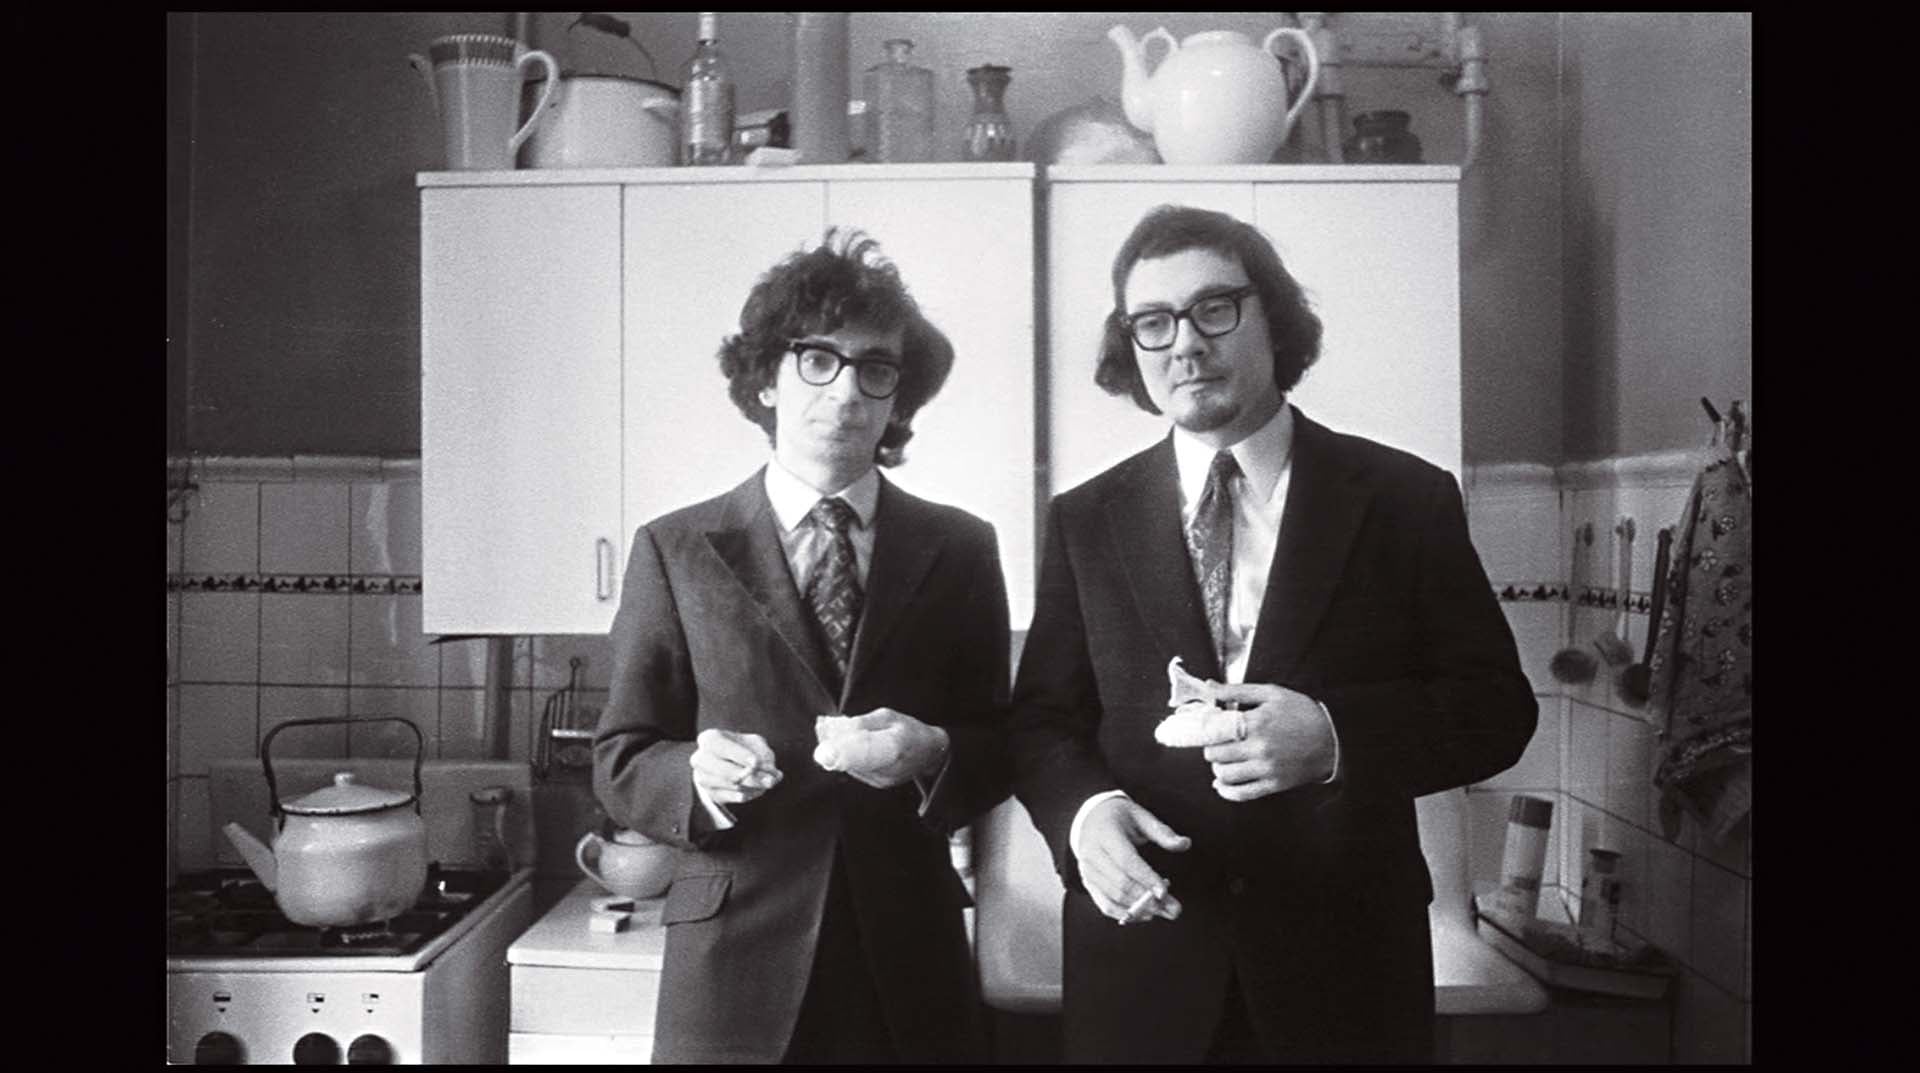
1993 年底至 1994 年間,俄羅斯藝術家維塔利.科馬爾(Vitaly Komar)與亞歷山大.梅拉米德(Alex Melamid)在類神經網絡仍受限於計算能力、人工智慧主要以數學與統計模型為主流的年代,發起了一項以「尋找共識」為核心的藝術創作計畫「人民的選擇」(The People’s Choice)。他們委託市場調查公司 Marttila & Kiley, Inc.,採取與調查消費者喜好相同的方式,調查美國人「最想要的畫」(most-wanted)與「最不想要的畫」(least-wanted)。
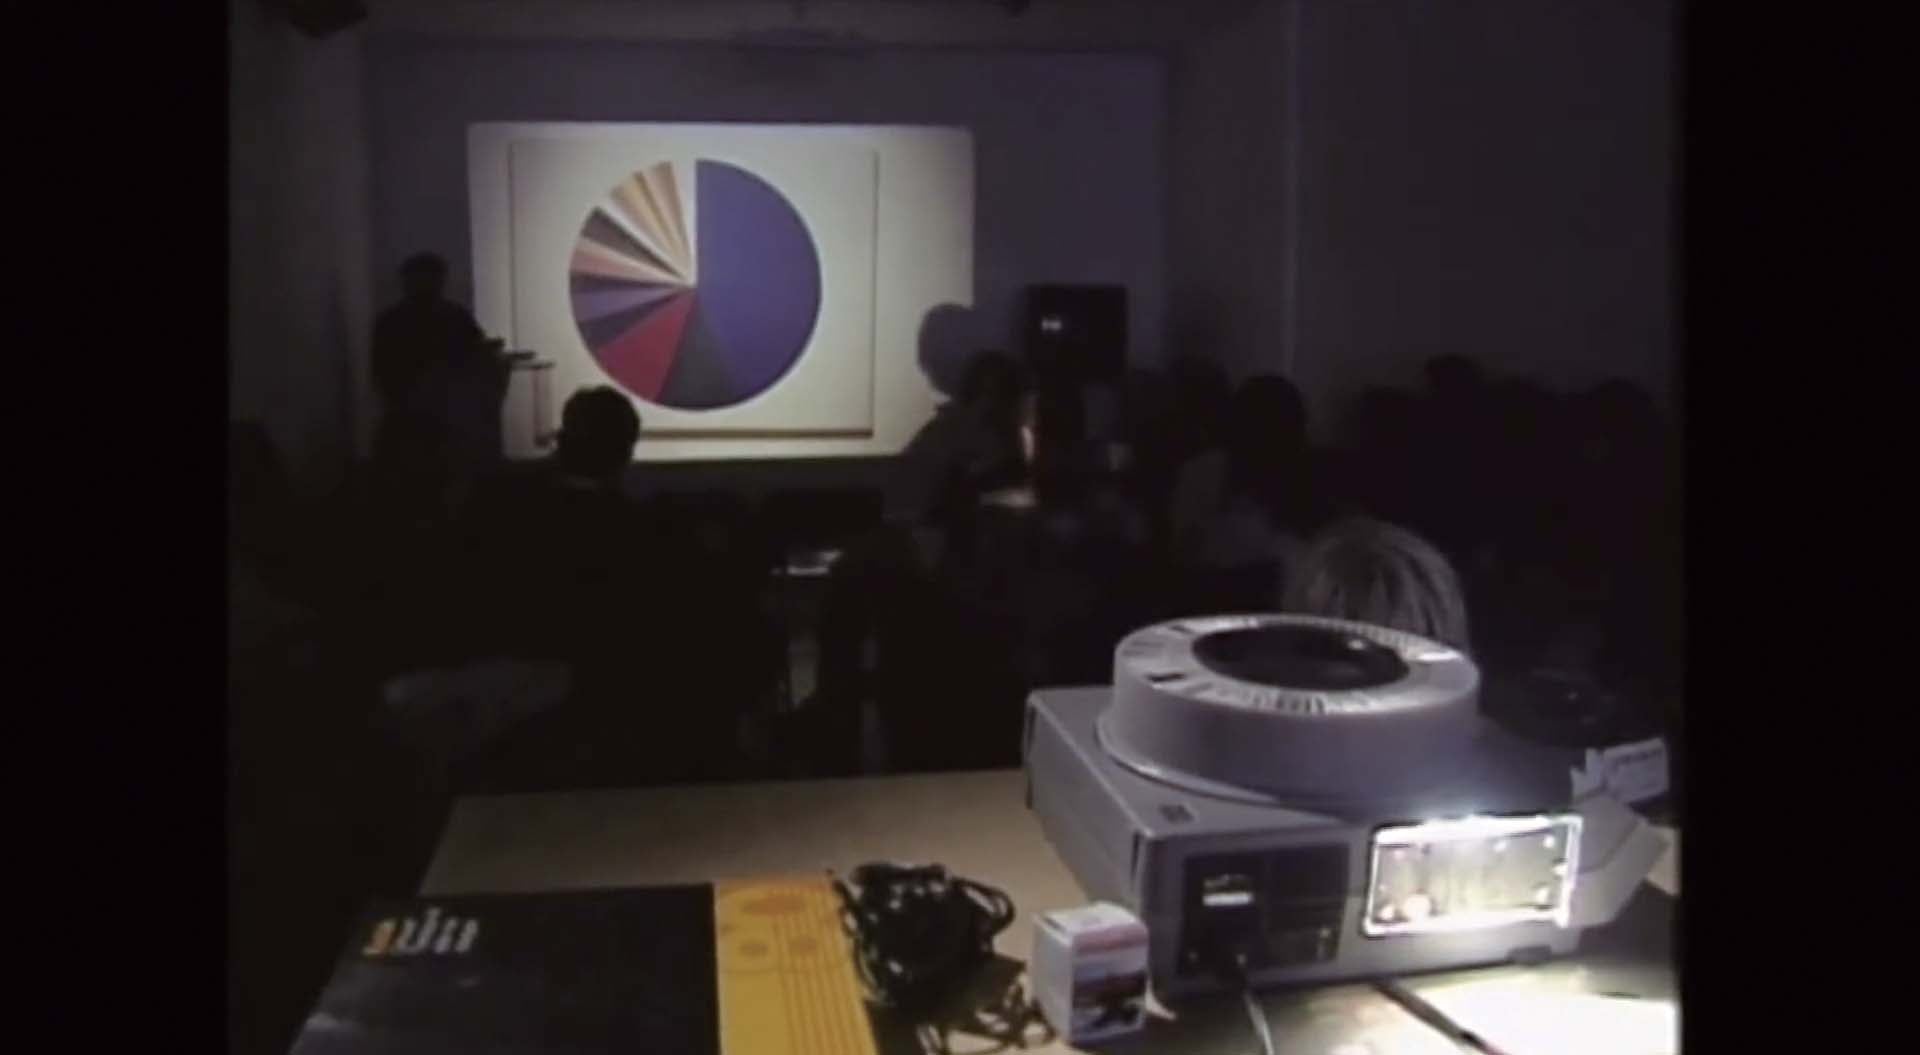
這項調查以抽樣的方式,電話訪問了 1,001 位美國成年人,樣本涵蓋美國本土48州,每次訪談平均約 24 分鐘。調查內容從形式到題材,涵蓋了相當細緻的視覺偏好:最喜歡什麼顏色?喜歡傳統還是現代藝術?喜歡抽象還是具象?喜歡看得見筆觸還是平滑的表面?顏色應該融合還是彼此分開?喜歡幾何圖形還是不規則形狀?喜歡室內還是戶外?山、湖、森林、海洋之中偏好哪一種?喜歡野生動物還是家畜?人物應該裸體還是穿著衣服?人物應該工作還是休閒?喜歡歷史人物還是當代名人?甚至連畫作的尺寸都被納入調查。
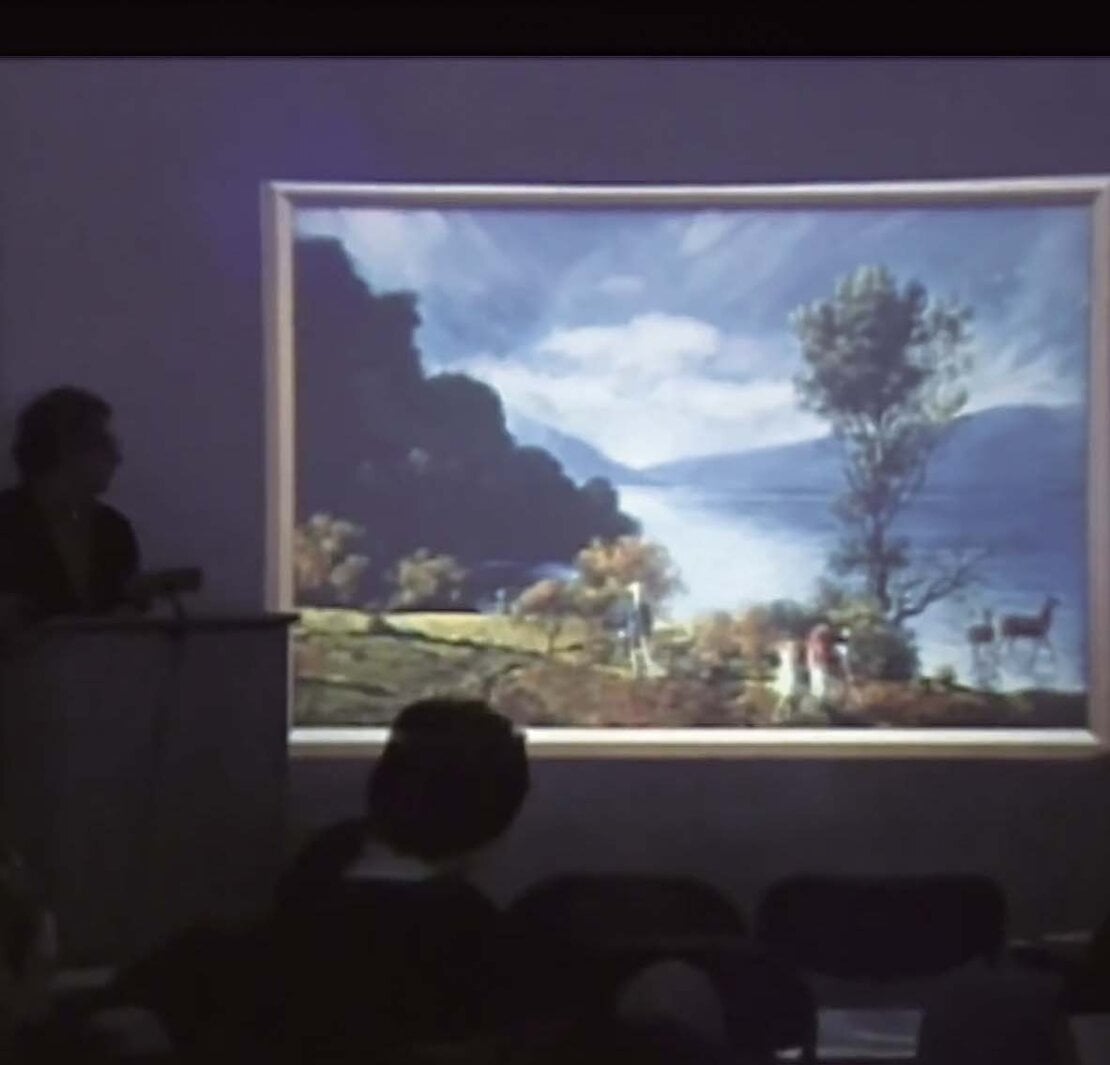
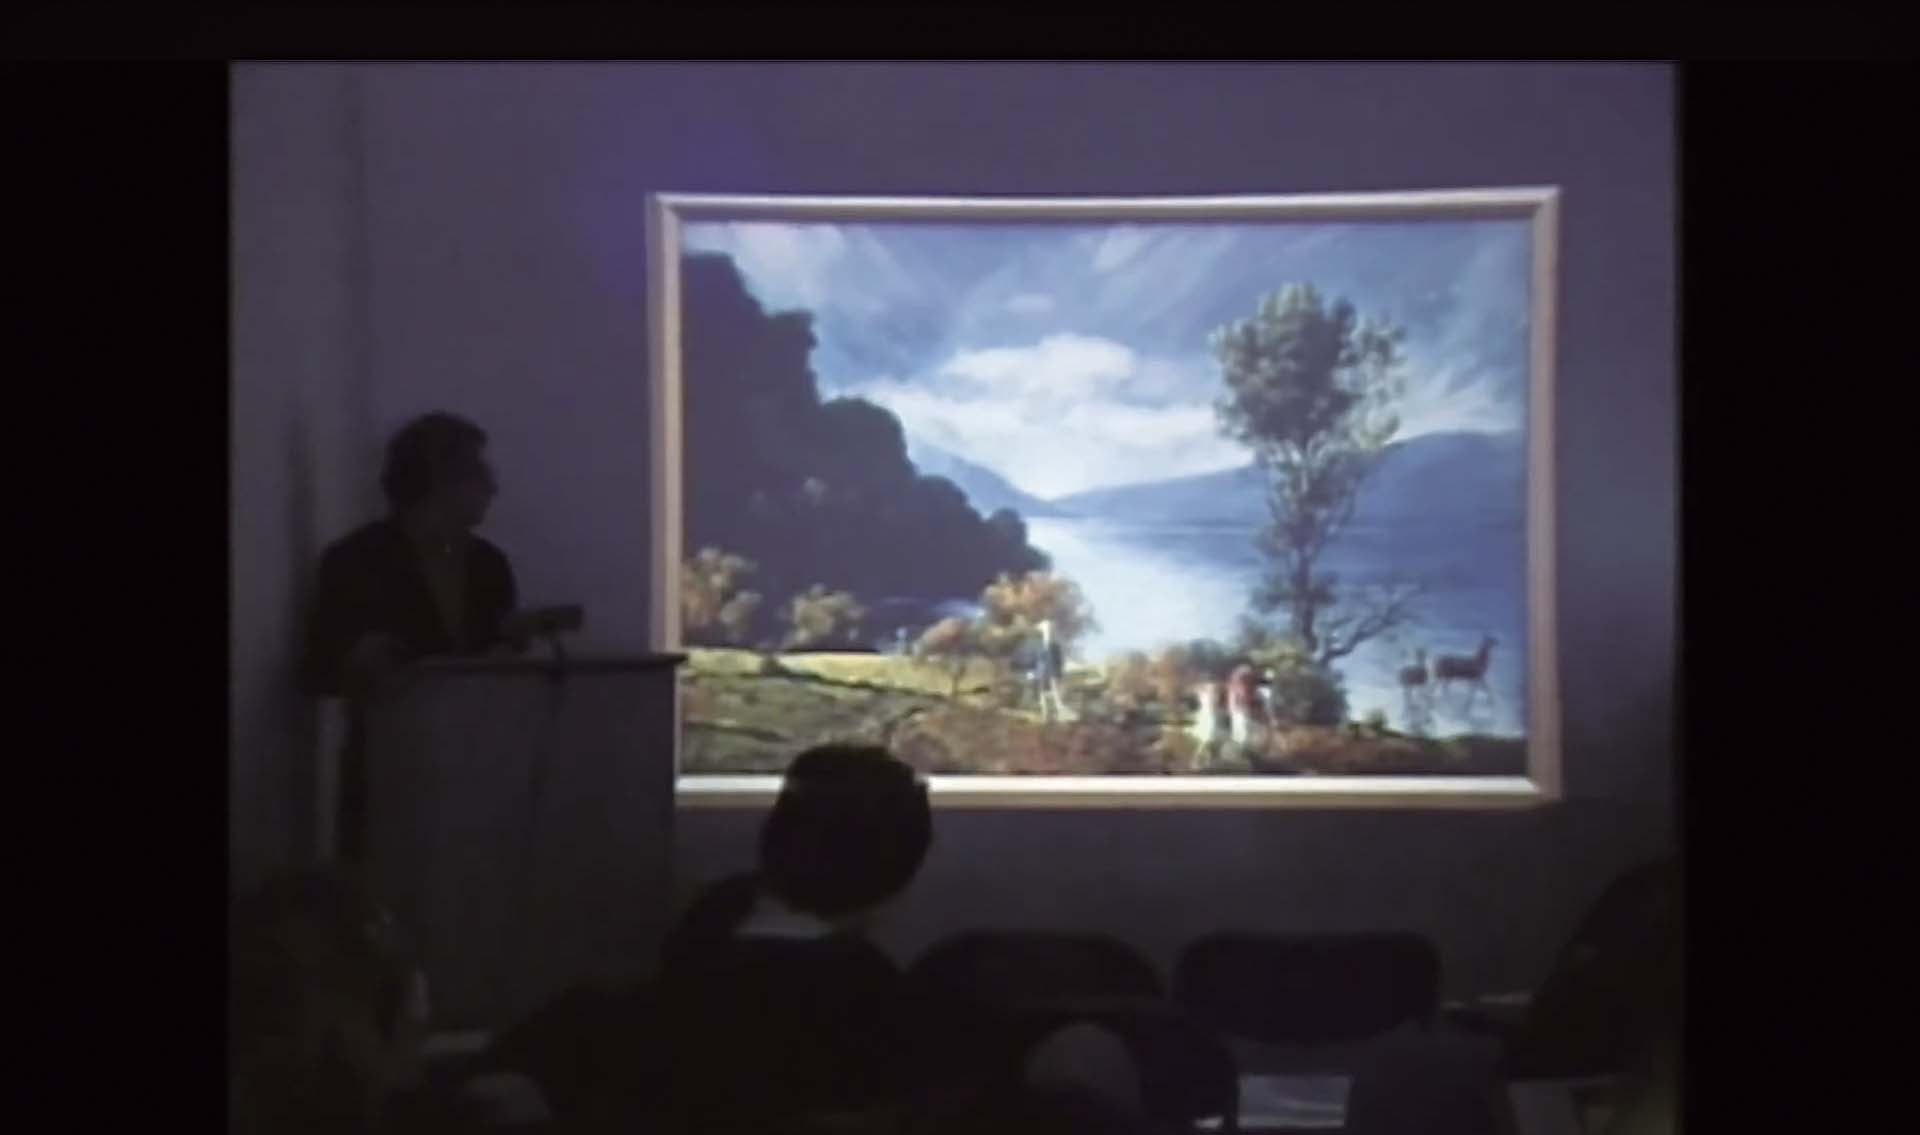
調查結果顯示,44% 的受訪者最喜歡藍色;64% 偏好傳統風格;71% 希望畫面簡單;68% 喜歡顏色彼此融合。調查完成後科爾馬與梅拉米德依據這些結果,繪製了《全美最想要》(America’s Most Wanted)與《全美最不想要》(America’s Least Wanted)兩件畫作。
前者是一幅洗碗機尺寸的寫實風景畫,湖泊、山、藍天、樹木、野生動物、休閒中的人物與歷史人物等各種受歡迎的元素被放置在同一個畫面之中,甚至還出現了華盛頓。而作品的尺寸,也依照調查結果被製作成大約洗碗機般的大小。這幅奇異的風景畫並不是某一個人真正想像出來的景色,而是將一系列在統計上受到歡迎的元素加以平均、拼接與折衷後的結果。
相對地,後者則是一幅平裝書本尺寸的抽象幾何作品:尖角、彼此分離的色彩,以及橘色、金色等較不受歡迎的顏色,共同構成了這幅「最不想要的畫」。
來自不同文化的相似共識
此後,他們將這項計畫延伸至橫跨四大洲的十多個國家,進行類似的調查,包括中國、丹麥、芬蘭、法國、德國、荷蘭、冰島、義大利、肯亞、葡萄牙、俄羅斯、土耳其、烏克蘭與美國等地。
有趣的是,藝術家原本期待,不同文化背景會產生截然不同的理想藝術型態,但調查結果卻出乎意料地相當接近:多數國家的受訪者都偏好19世紀式的風景畫、自然景色、藍色、水域與具象描繪,而幾何抽象藝術則普遍較不受歡迎。少數差異包括荷蘭受訪者相對偏好抽象藝術,以及法國受訪者在人物裸體的偏好上呈現不同傾向。
如果我們相信「不同文化擁有各自獨特的審美」,那麼這些調查結果似乎反而指向另一個方向:經過統計之後,人們的偏好,可能並沒有想像中那麼不同。
在「演算法推薦」與「生成式 AI」尚未出現的年代,甚至在全球化程度尚未如今日如此高度普及的時代,「人民的選擇」的操作邏輯,卻已經非常接近我們今日所熟悉的一種內容生產模式:蒐集人的喜好、找出其中的統計模式,再生產出最有可能被喜歡的內容。如果創意也可以被理解為一種對既有形式的重新組合,那麼這樣的統計與生成機制,似乎也已經觸及了創意生產的某個部分。
藝術與創意,是否該偏離共識?
然而,如果一件藝術作品能夠滿足多數人的喜好,它就會因此成為「最好的」作品嗎?「最受歡迎的特徵」彼此相加,並不等於「最好的作品」,甚至不等於任何一個人真正想要的作品。《全美最想要》完成之後,反而有人認為它無聊、陳腔濫調,甚至像是廉價商店裡的裝飾畫。
曾於 1995 年委託兩位藝術家將此計畫發展為網路藝術專案的迪亞藝術基金會( Dia Art Foundation),日後在回顧「人民的選擇」時,也從另一個角度指出:作品最終呈現出的平庸,或許恰恰暴露了民調形式本身的侷限。問卷並非單純地捕捉既有的欲望,而是在調查過程中,將人的欲望重新塑造成一組被縮減、簡化的選項。當人只能回答「藍色或紅色」、「抽象或具象」、「山或湖」,最後得到的,也就只能是這些有限選項經過統計之後所形成的拼貼結果。
另一方面,「人民的選擇」本身也並非單純地試圖透過統計結果尋找一種「大眾真正喜歡的藝術」。這項計畫同時帶有後設性的批判與諷刺意味:當藝術被拆解成一連串可以被調查、量化與統計的偏好時,我們是否反而暴露了「共識」本身的侷限?
而這也使「共識」與「創意」之間產生了一個值得追問的矛盾:如果共識意味著找到多數人已經能夠辨識、理解與接受的模式,那麼創意是否恰恰可能發生在偏離共識的地方?當 AI 透過大量資料學習人類的偏好,從中尋找規律,再生成「最可能符合期待」的結果時,它所學習的究竟是人的審美,還是被資料化、選項化之後的「審美共識」?而當它能夠在既有模式中產生新的組合時,這種「新」究竟是一種創意,還是統計意義上的偏差與變化?
「人民的選擇」所揭示的,或許正是這個問題的另一面:藝術所仰賴的基石,也許並不只存在於個體與群體之間那些可以被歸納的「相似」之中;那些無法被統計、無法被平均,甚至彼此矛盾的「相異」,可能才是藝術與創意發生與存在的地方?(文/陳姿尹)
二、當「創意」成為一個工程問題
如果產品經理走過來說:「我們希望下一版模型更有創意」,工程師多半會先愣一下,接著問:「你說的創意,具體是什麼?」
機器學習習慣處理可以被量化的問題。語音辨識有「字錯率」(word error rate,WER),影像分類有準確率,生成模型也有各種品質、相似度與偏好指標。但「創意」很難直接變成一個數字。一個有創意的結果,當然不能只是重複過去;可是一旦新奇到與題目毫無關係,也很難說它是一個好的答案。
這也回應了第一章留下的問題:如果 AI 擅長從大量資料中尋找共同模式,那麼創意是否就發生在「偏離共識」的地方?從工程角度來看,偏離確實很重要,但偏離本身並不等於創意。真正困難的,是判斷哪些偏離值得留下。
離共識越遠,就越有創意嗎?
在工程與研究中,「偏離既有模式」常會被近似成某種可計算的距離。其中一個很直接的例子,就是發散聯想測驗。
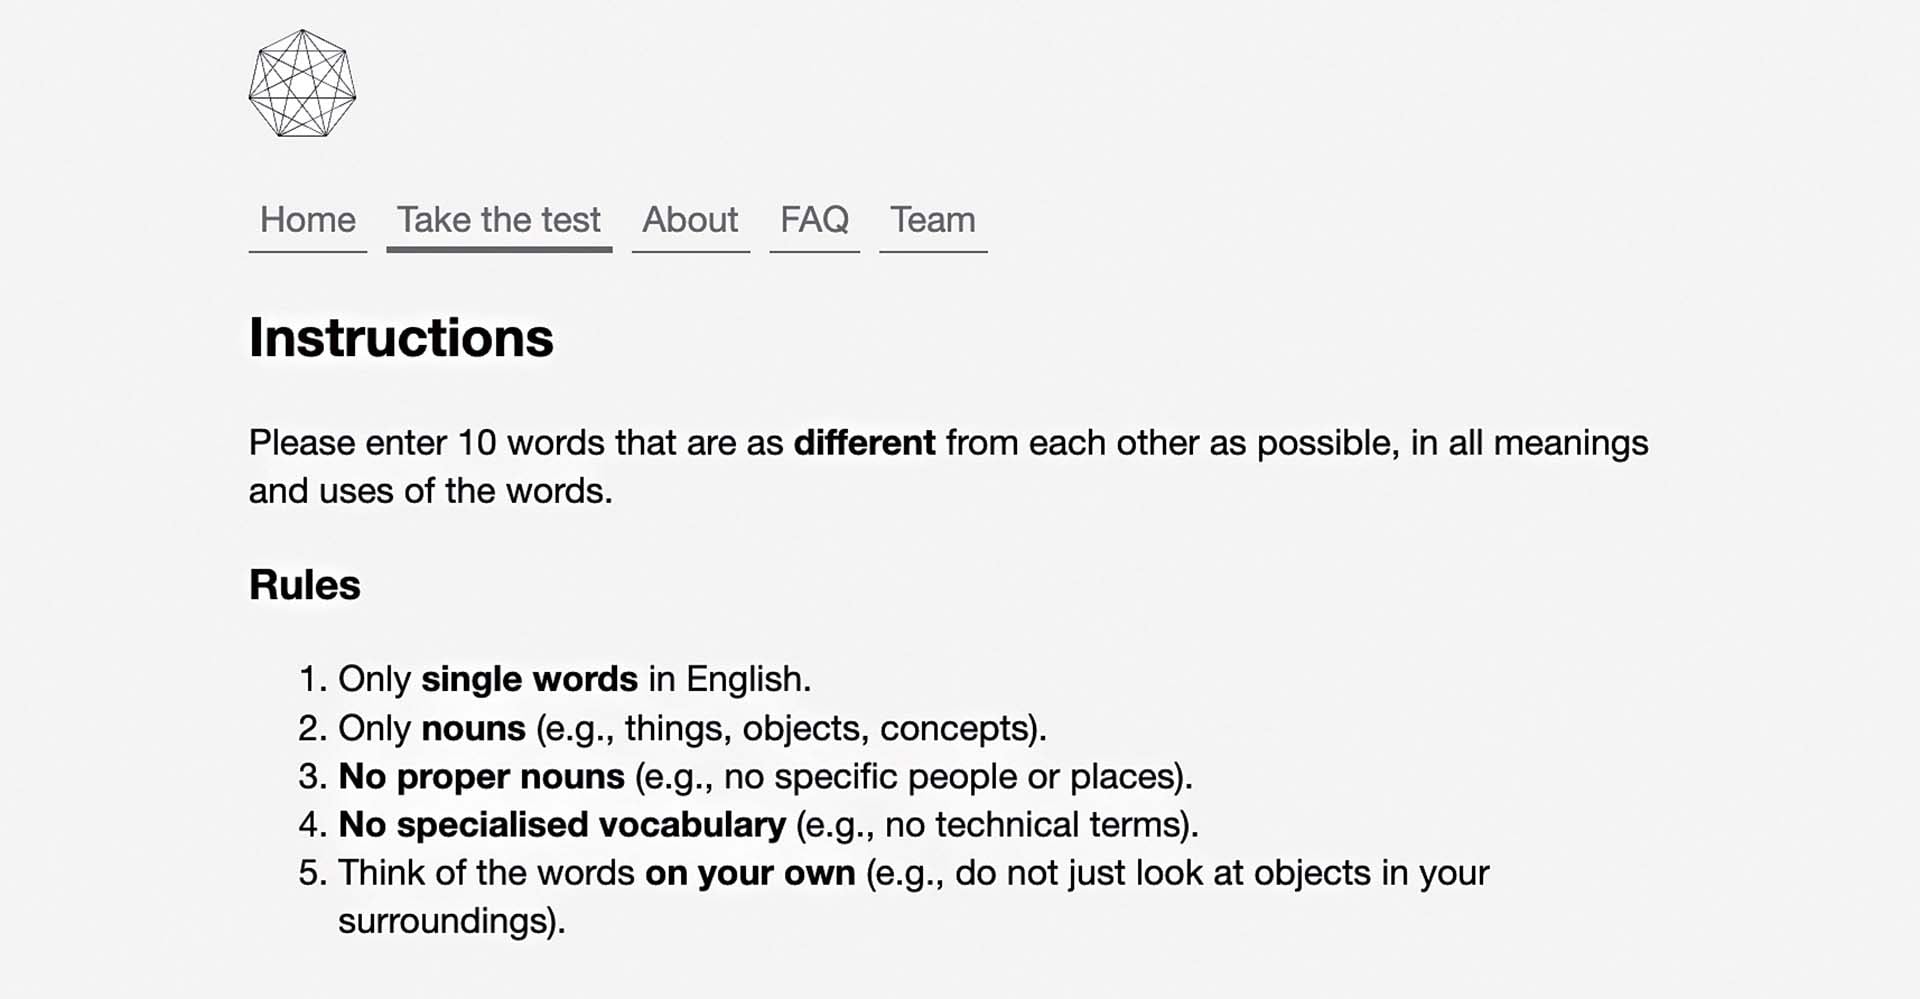
「發散聯想測驗」(Divergent Association Task,DAT)要求受試者提出數個在語意上盡可能彼此不同的詞。例如「鋼琴、火山、法律、細菌、月亮」,如果這些詞在語意空間中的距離很遠,便會得到較高的分數。它背後的直覺很直接:如果受試者總是想到彼此相近的事物,他的思考可能比較集中;如果能跳到相距很遠的概念,則代表他的聯想比較發散。DAT 並不是完整衡量「創意」本身,而是以語意距離作為發散思考(divergent thinking)的一項可計算指標。
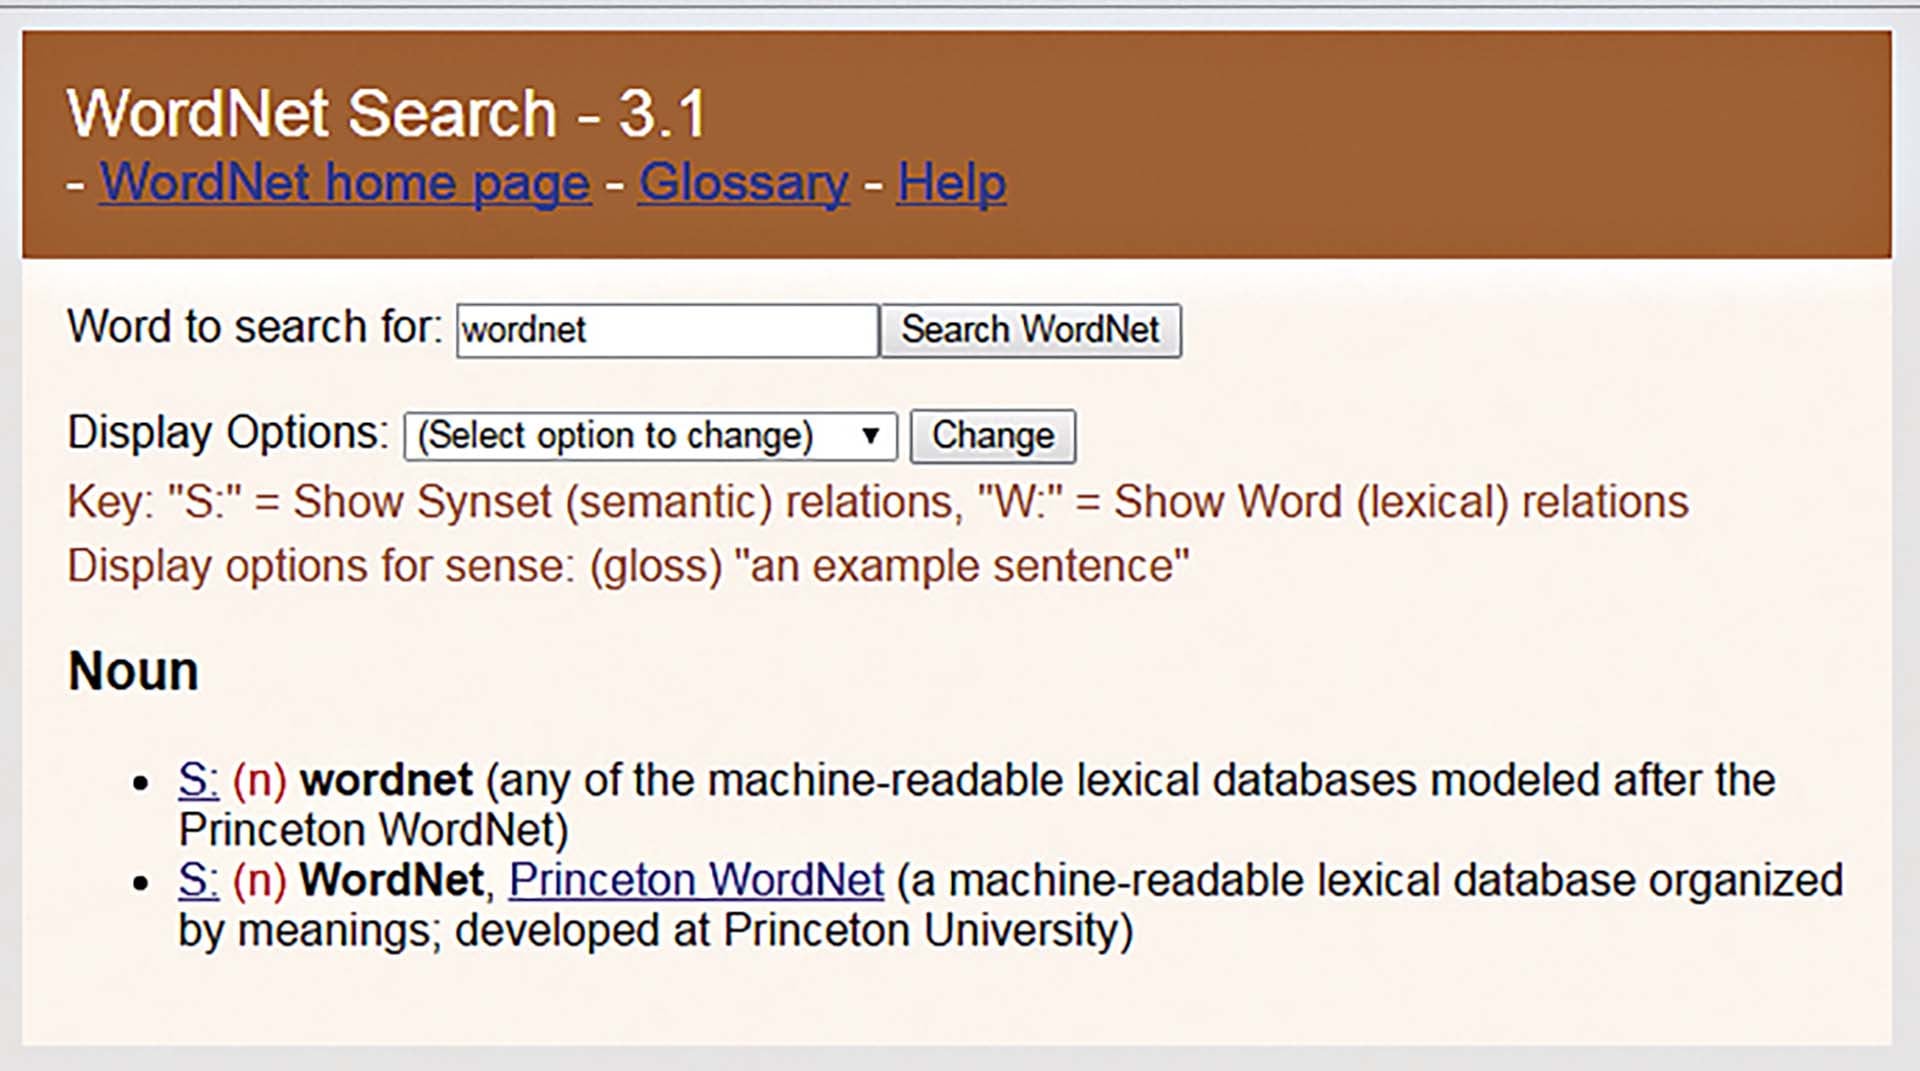
中島(Nakajima)等人(2026)指出,如果評估方式主要獎勵「彼此有多不一樣」,那麼隨機性也可能被誤認成創意。假如模型回答「胰臟、條約、蚊子、花崗岩、女高音、甘藍、軌道」,這些詞的確彼此相距很遠,但很難因此說模型產生了什麼有意義的創意。研究甚至發現,隨機從 「WordNet」(由普林斯頓大學開發的英語認知詞彙資料庫) 抽取名詞,也可能在這類測驗中得到很高的分數。換句話說,DAT 的高分不一定代表更有創意,它也可能只是反映答案彼此距離很遠,甚至只是更隨機。
因此作者進一步提出條件式「發散聯想測驗」(Conditional Divergent Association Task,CDAT)。它不只要求答案彼此不同,還增加一個情境詞。例如給定「海洋」,回答可以是「珊瑚、潛水艇、遷徙、地平線、鹽、神話、貿易」。這些詞跨越生態、科技、景觀、文化與經濟等不同面向,彼此之間差異很大,但又都能合理地回到「海洋」。
在創意研究中,一個廣泛被引用的工作定義,是將創意理解為同時包含「原創性」(originality)與「有效性」(effectiveness)兩項條件;換句話說,一個結果不只需要足夠新穎,也必須在特定情境中具有適切性、實用性或價值(Runco & Jaeger, 2012)。
CDAT 因此把這類創意表現拆成兩個方向:「新穎性」(novelty)與 「適切性」(appropriateness)。想得不一樣是一件事,想得不一樣卻仍然與情境產生關係,是另一件事。只有追求前者,很容易得到隨機雜訊;只有追求後者,答案又可能安全、合理,卻毫無意外。研究也因此不再試圖把兩者硬壓成單一分數,而是把模型放在 novelty–appropriateness 的取捨關係中理解,這種取捨也很接近實務上真正面對的問題。
這其實也很接近工程實務。真正需要決定的,通常不是「模型有幾分創意」,而是我們願意接受什麼樣的取捨:希望它多新、多偏離既有模式,又必須保留多少切題性與有效性。換句話說,產品最後需要的是一套可操作的工作定義:我們要的是哪一種創意?允許偏離共識多遠?什麼樣的偏離仍然有價值?
「人民的選擇」在這裡也形成了一個有趣的對照。第一章指出,過度服從共識可能得到一幅人人都熟悉、卻乏善可陳的作品;但反過來說,單純遠離共識也不會自動產生創意。相異可能是創意發生的重要來源,但光有相異還不夠,問題真正落在:這個相異與什麼產生了關係?又是誰判斷這個關係有沒有意義?
AI 學到的,是審美,還是共識?
同一句提示詞交給不同的圖像模型,結果經常有完全不同的氣質。有些模型偏寫實,有些容易生成動畫、電影感或精緻插畫。表面上像是模型擁有自己的「品味」,但從機器學習的角度,它其實是在訓練資料所形成的表示空間裡重新組合概念。
模型看過什麼、哪些資料出現得更多、哪些資料在清理階段被保留下來,都會影響它所學到的「共識」長什麼樣子,也會讓某些結果比其他結果更容易被生成。而且,這種「共識」並不是只在模型最初學習資料時形成。當模型進一步被調整成更符合人的期待時,人類的偏好也會開始更直接地參與其中。
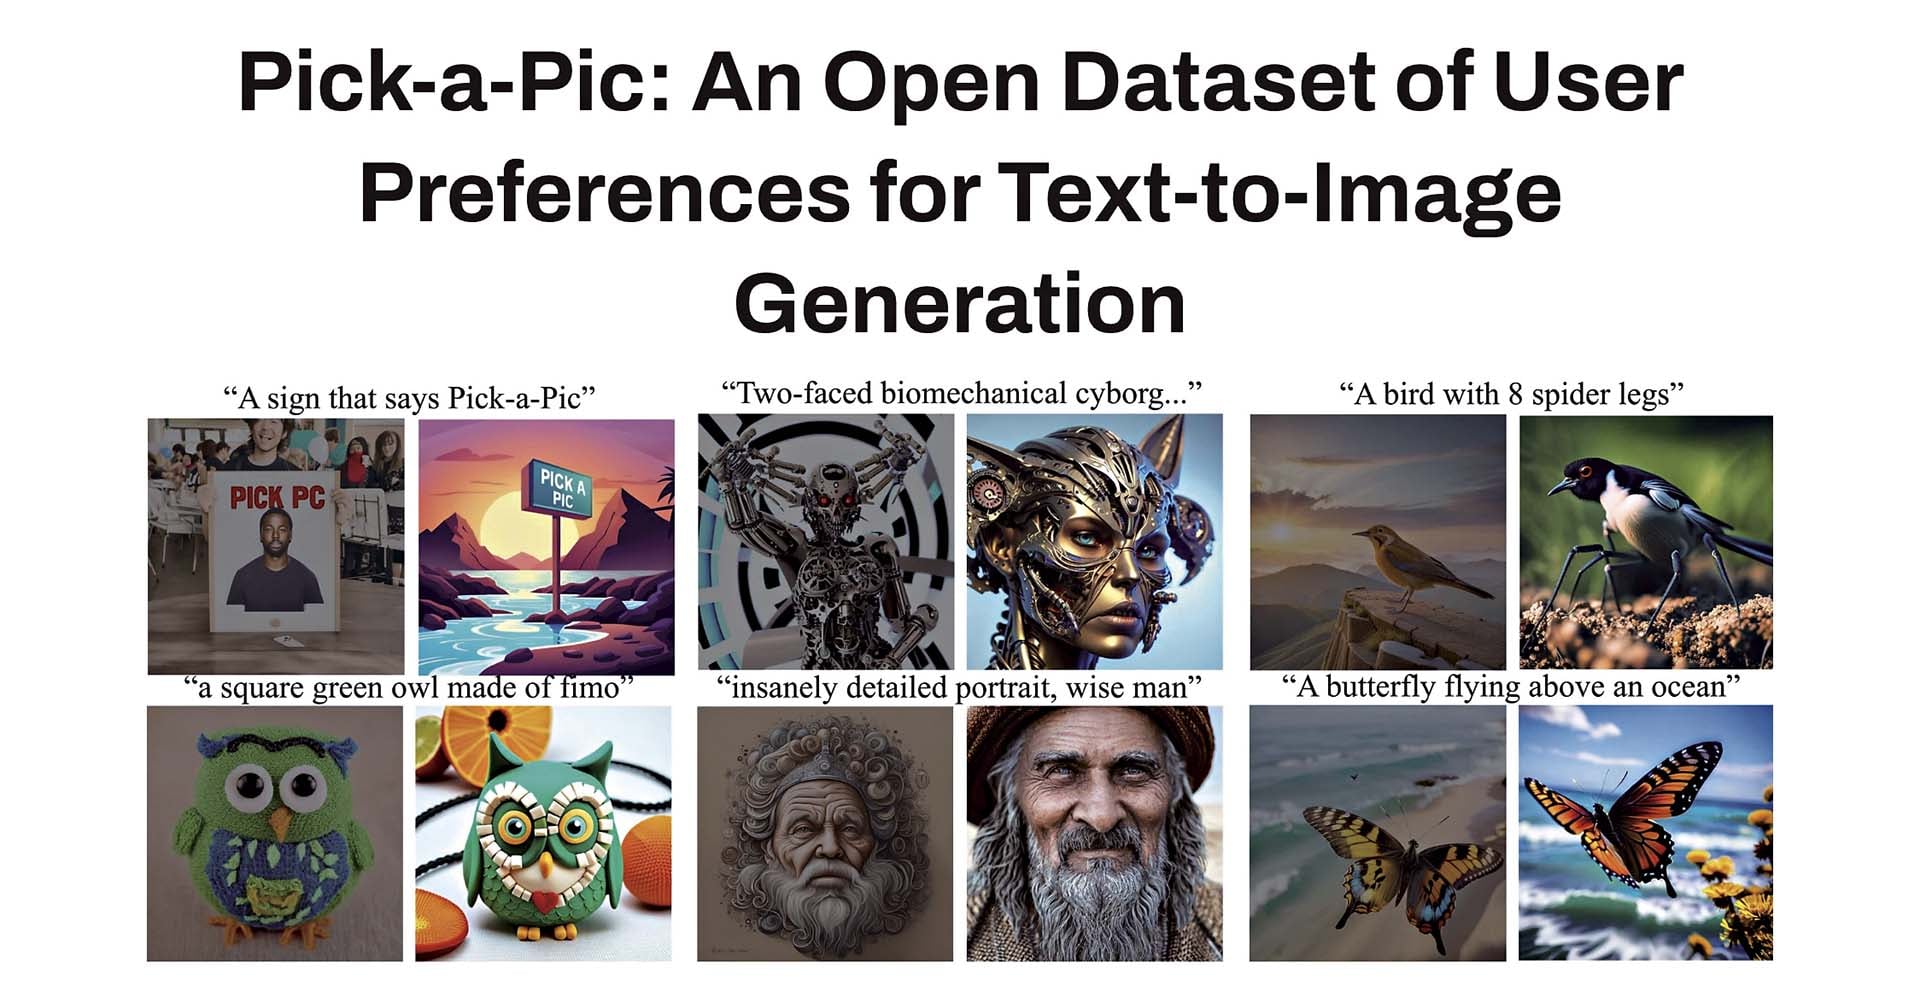
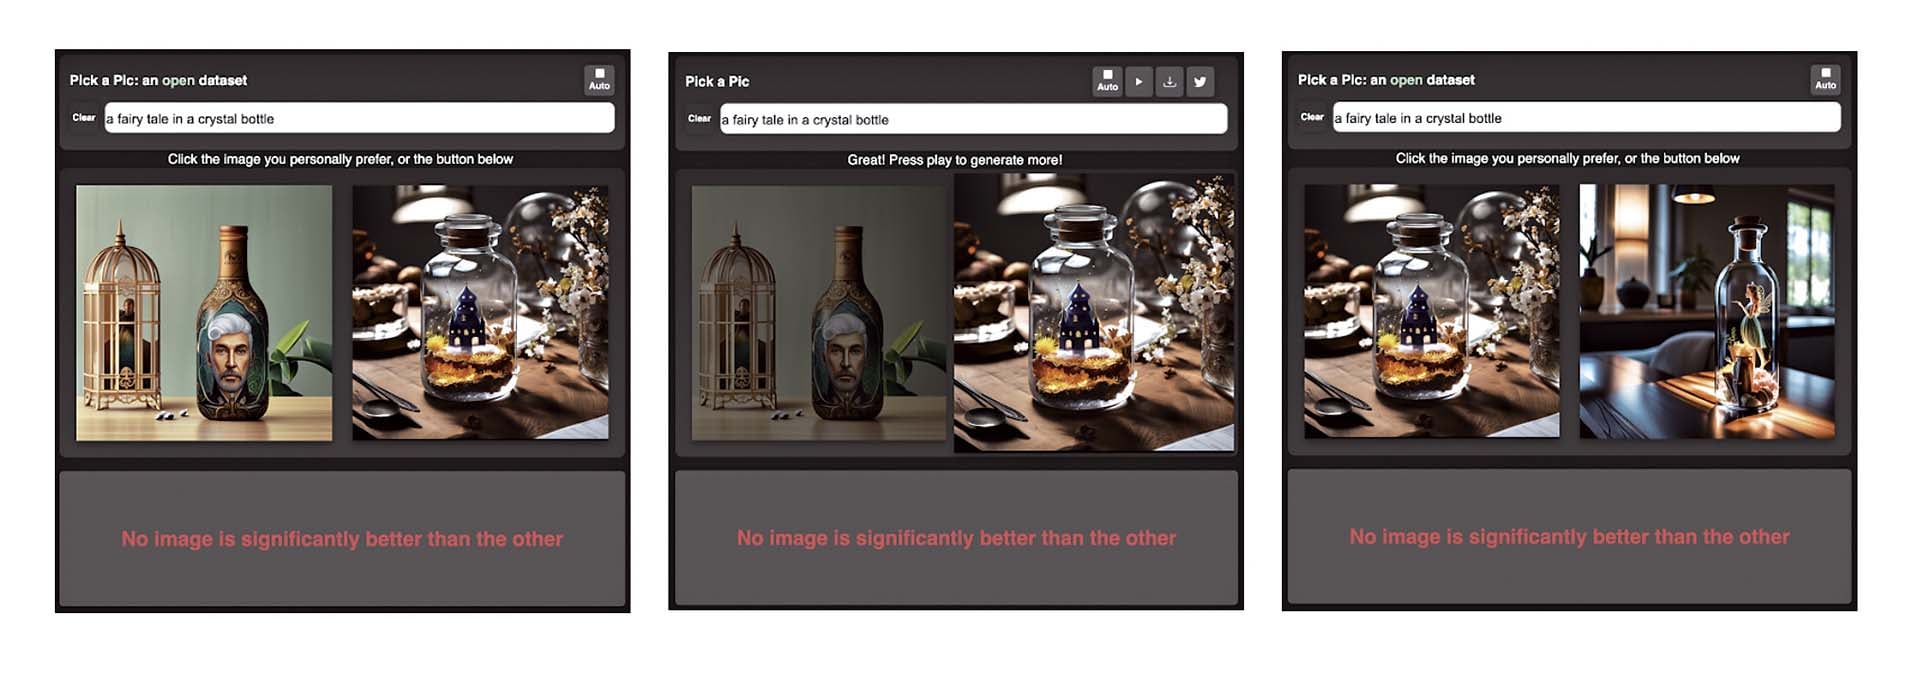
以文字生成圖像為例,「Pick-a-Pic」讓使用者觀看兩張由相同提示詞產生的圖片,再選出自己偏好的一張。大量這類選擇累積起來之後,「我比較喜歡這張」便從一個主觀判斷,變成模型可以學習的訊號。這類偏好資料,也可以進一步成為調整模型的重要依據。
從這個角度來看,「人民的選擇」和今天的生成式 AI,其實沒有想像中那麼遠:兩者都先蒐集人的選擇,再從中找出統計上的規律。差別在於,「人民的選擇」最後產生的是一幅畫;今天的偏好資料則可以進一步被用於模型評估、排序,乃至於後續的模型調整,影響模型未來更傾向產生哪些結果。
但「更容易被喜歡」並不必然等於「更有創意」。如果使用者不斷選擇相似的構圖、光線與人物外型,模型便會越來越擅長產生這些內容。那些少見、冒險、難以立即理解的結果,則可能逐漸被推向分布的邊緣。原本只是「多數人比較喜歡什麼」,久而久之就可能成為模型的預設答案。
「AI 學到的是人的審美,還是資料化之後的審美共識?」若從工程實務來看,我會更傾向後者。模型接觸不到抽象的「人類審美」本身,它真正接觸的是被我們成功轉換成資料的那一部分:哪些作品被蒐集、哪些被刪除、標註者喜歡什麼、使用者點了哪一張,以及工程團隊最後決定獎勵哪些結果。換句話說,模型所學到的「共識」並不是中立的結果,而是由資料選擇、人類偏好與後續訓練共同塑造出來的。
創意可以離共識多遠
做「文字轉語音」(text-to-speech,TTS)時,使用者常說:「希望這個聲音更有情緒。」到了工程端,這句話必須被拆成音高、能量、停頓、語速、語調與說話風格等可以操作的因素。但麻煩在於,這些變化都不是越大越好。
變化太少,每次生成都非常一致,聲音卻可能僵硬;變化太大,模型偶爾可能給出很有感染力的演出,也可能突然使用完全錯誤的語氣。一句原本平靜的旁白,第二次生成時忽然變成質問。同樣的變化,在創作工具裡可能是驚喜,放進客服系統卻可能是錯誤。
所以工程上真正要處理的,並不是「如何把創意開到最大」,而是替模型畫出一個可以活動的範圍。我會把它想成一個 「創意的活動範圍」(creative envelope):模型可以離開最符合共識、最安全的答案多遠;又要在什麼地方被拉回來。
在生成時,如果總是偏向模型認為機率最高的答案,結果通常比較穩定;如果增加隨機性,輸出會更多樣,但失敗與離題的機率也可能一起增加。因此,工程師所做的「創意工程」,很少是在教 AI 什麼叫創意,比較像是在多樣性、容錯空間、可控性、穩定性、安全性之間,決定哪些偏離可以被保留下來。
第一章從藝術創作者的視角指出,創意可能存在於那些無法被平均的「相異」之中;但發散聯想測驗也提醒我們,光是追求相異,得到的也可能只是隨機。因此真正困難的問題是:什麼樣的「不一樣」值得被保留下來?
工程可以透過資料、評估與偏好學習,改變哪些答案更容易出現;但如果創意除了原創性,也需要有效性,那麼「有效」究竟是對誰而言?又由誰判斷?這個問題,就又從工程回到了人。(文/陳宣伯)
三、「原創性」與「有效性」,由誰、如何評斷?
常常有初認識的策展人問我們:「你們最喜歡的藝術家是誰?」,或者有些會更直接地問:「有沒有哪位藝術家是你們想成為的模板?」雖然我們已經被問了好多次,但每次都還是像第一次被問到這個問題的時候一樣,會先愣一下,然後始終答不好這個問題。
在還沒有足夠時間(或意願)好好了解剛認識的藝術家的作品與創作脈絡的時候,用「模板」的方式理解,確實是最容易快速有大致想像輪廓的方法。在學習或是練習成為一名藝術創作者的歷程中,從模仿中學習亦是多數人的必經之路。受喜歡的藝術家影響,乃至於「致敬」與「模板」,往往與「抄襲」僅有一線之隔,又或者稍微溫和一點說法可能會是「不夠有創意」。
或許這也是我們始終答不好這個問題的原因,尤其在生成式 AI 的時代,模板的概念實在是「很AI」。AI的演算原理可以很簡單的理解為計算資料的分布狀況,也就是尋找資料之間的關係,分布越集中,越容易被模型學習,又或者說是越容易被找到某種趨勢、模式、風格。
難以辨認的原創性
若沿用馬克.朗科(Mark A. Runco)與蓋瑞特.傑格(Garrett J. Jaeger)對創意的標準定義,創意必須同時包含原創性與有效性,兩者缺一不可。然而在生成式 AI 與推薦系統共同塑造資訊環境下,原創性或許愈來愈容易淹沒在大量生成的輸出之中,而有效性是否成立,卻仍然仰賴人類的介入與判斷。
在全球化與資通訊科技發展下的液態社會裡,一方面,來自不同國家、文化的人,所接受來自外部的「刺激」越來越相近,機器學習模型又往往較容易學習資料中反覆出現、具有穩定統計規律的模式,進而使這種趨同現象更容易被延續與放大;另一方面,即便接收資訊的效率也獲得提升,然而資訊生產過載與投其所好的推薦演算邏輯,使得人們被困在「回聲室」(Echo Chamber)的同時,反而很容易對於接觸到回聲室之外的資訊感覺到「新穎感」。
這也可能使我們對「新穎」的判斷變得更加情境化:一個內容究竟是真的少見,還是只是第一次穿過個人的資訊邊界,開始變得難以區分。「原創性」(originality)也因此變得越來越難以辨認。
相較之下,有效性給人的感受更加直接,也更容易透過某些外顯結果被感知;在社群平台與市場環境中,又進一步被點閱數、使用量或經濟效益等量化指標作為衡量依據。
藝術創作的類型眾多,田野調查型、媒材實驗型、社會觀察型、議題倡議型、哲學思考型、感官刺激型等,不勝枚舉。不同類型對於「原創」的需求程度與定義亦不盡相同。近數十年來,隨著當代藝術中的「研究轉向」,研究型藝術創作逐漸成為常見的創作方式。藝術家不再只是製作一個物件或影像,而可能為了一件作品進行田野調查、閱讀學術文獻、訪談專業人士、學習程式設計、研究某項科學技術,甚至進入原本與藝術相距甚遠的專業領域。於是,藝術創作與通常所理解的「研究」之間,也開始出現愈來愈多重疊之處。
羅賓.尼爾森(Robin Nelson)在《藝術中的實踐即研究》(Practice as Research in the Arts)裡談到,研究型藝術創作比起學術研究,嚴謹性存在於綜攝、融匯與整合(syncretism),而不一定存在於對單一領域不斷「向下深挖」(depth-mining)。相較於某些以既定學科為範圍、針對特定問題持續深化的研究路徑,藝術家的研究往往從一個問題、經驗或創作動機出發,在不同的知識領域、技術、材料、歷史脈絡與日常經驗之間移動,並嘗試建立原本並不明顯關聯的「橫向連結」,也就是某種關係的建立、知識的轉譯,以及異質事物之間新的組合方式,並以此作為一種「原創」的方式。
很不巧地,大量產生並嘗試建立不同概念之間的「橫向連結」,又是 AI 最擅長的任務之一。AI可能難以精準地抵達使人感覺到「創意」的橫向連結,但其低成本、快速的特性,亂槍打鳥打中的那幾隻在某些時候其實已經足以滿足需求。捫心自問,不得不承認在嘗試使用AI進行發想的經驗中,雖然頻率不高,但也並不是完全沒有對於AI給的回覆感受到「有效創意」的經驗。
有效的創意萌生,最終仍然回歸於人
如此說來,AI 作為某種創意發想外部化的工具,似乎並非不可行。對於身為藝術創作者而言,理應感覺到一點懷疑自我價值的焦慮,然而現實則不然,我認為其主要原因為—有效性的萌生,需要人類的介入。
從第二章的論述之中其實可以推敲出一二,演算法工程師所做的「創意工程」,實質上是在多樣性、容錯空間、可控性等考量之間進行權衡。亂槍不可以太亂,否則難以達到「有效性」;彈著點也不能太一致,否則難以產生「原創性」。而所謂的「有效」與否的最終決定權,則來自人類使用者的判斷。並且就如同文章第一章對「人民的選擇」的作品分析,人類的判斷又來自於個體與群體之間,相似與相異的日常經驗、知識與偏好。(文/莊向峰)
參考書目
Komar, V., & Melamid, A. (1997). Painting by numbers: Komar and Melamid’s scientific guide to art (J. Wypijewski, Ed.). Farrar, Straus and Giroux.
Dia Art Foundation. (n.d.). United States. In The Most Wanted Paintings on the Web. https://awp.diaart.org/km/usa/usa.html
Gill, K. M. (2020, April 24). Artist Web Projects Spotlight: Vitaly Komar and Alex Melamid, The Most Wanted Paintings, 1995. Dia Blog. https://www.diaart.blog/home/spotlightkomarandmelamid
Olson, J. A., Nahas, J., Chmoulevitch, D., Cropper, S. J., & Webb, M. E. (2021). Naming unrelated words predicts creativity. Proceedings of the National Academy of Sciences, 118(25), e2022340118. https://doi.org/10.1073/pnas.2022340118
Kirstain, Y., Polyak, A., Singer, U., Matiana, S., Penna, J., & Levy, O. (2023). Pick-a-Pic: An open dataset of user preferences for text-to-image generation. Advances in Neural Information Processing Systems, 36, 36652–36663.
Nakajima, K., Zuiderveld, J., & Pezzelle, S. (2026). Beyond divergent creativity: A human-based evaluation of creativity in large language models. Findings of the Association for Computational Linguistics: EACL 2026, 2639–2660. https://doi.org/10.18653/v1/2026.findings-eacl.138
Runco, M. A., & Jaeger, G. J. (2012). The standard definition of creativity. Creativity Research Journal, 24(1), 92–96. https://doi.org/10.1080/10400419.2012.650092
Nelson, R. (2013). Practice as research in the arts: Principles, protocols, pedagogies, resistances. Palgrave Macmillan.